
005.说一说特征预处理
文章目录
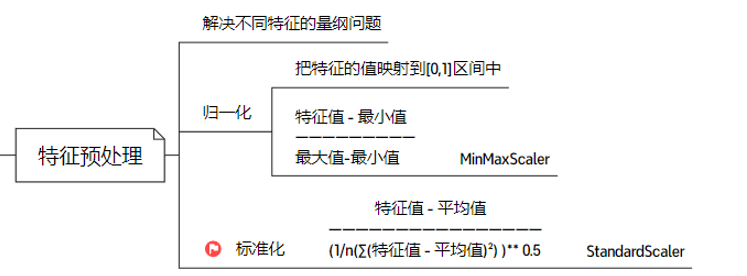
一、 核心定义(面试标准答案)
特征预处理(Feature Preprocessing):
指在将数据喂入模型之前,对原始特征进行变换、编码、缩放等一系列操作。其根本目的是消除特征间的量纲(尺度)差异,防止数值范围大的特征主导模型训练,同时加速梯度下降的收敛过程。
二、 两大核心缩放技术深度剖析(针对你的笔记填充)
你的笔记提到了两个公式,但面试官绝不会只问公式。你需要掌握以下底层逻辑与致命缺陷:
1. 归一化 / 离差标准化(Min-Max Normalization)
- 公式:
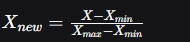
- 输出范围:默认映射到 **[0, 1]**(也可通过
feature_range参数映射到 [-1, 1])。 - 核心痛点(面试必问):对异常值(Outlier)极其敏感!
- 举例:员工收入特征,99%的人在 0-50万,但马云身价 1000亿。此时 ( X_{max} ) 被拉到 1000亿,导致所有正常人的归一化结果全部坍缩到接近 0,信息大量丢失。
- 适用场景:图像处理(像素值固定 0-255)、神经网络输入层(要求数据在 0-1 之间且无边界的激活函数如 Sigmoid)。
2. 标准化 / Z-Score 标准化(Standardization / Z-Score Normalization)
- 公式:
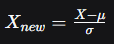 (其中
 为均值,
 为标准差)
- 输出范围:无固定边界,但绝大多数数据会落在 [-3, 3] 区间,均值为 0,方差为 1。
- 核心优势(面试必问):受异常值影响远小于归一化。
- 因为标准差
 和均值 虽受异常值影响,但远没有最大最小值那么剧烈。
- 因为标准差
- 适用场景:大多数机器学习算法(SVM、KNN、K-Means、PCA、逻辑回归、线性回归),因为这些算法依赖距离(欧氏距离)或方差(协方差)。
三、 面试加分项(别人不说的进阶细节)
如果你能在回答中顺带抛出以下3点,面试官会认为你是有实际调参经验的人:
- 标准化 ≠ 归一化(中文翻译陷阱):
- 在英文文献中,很多人把
StandardScaler叫“归一化”,但在中国面试中,务必区分:归一化特指MinMaxScaler,标准化特指Z-Score。你主动厘清这一点,立刻加分。
- 先拆分,再拟合(Data Leakage 数据泄露):
- 致命错误:先对全量数据做
fit_transform,再拆分训练集和测试集。 - 正确做法:只用训练集
fit(计算训练集的 min/max 或 mean/std),然后用训练集的参数去transform验证集和测试集。因为生产环境没有未来数据,测试集的极值不能参与训练集均值的计算。
- 不需要缩放的特征(反常识):
- 树模型(XGBoost、LightGBM、随机森林) 不需要做标准化/归一化!因为树模型是按特征值分裂节点(比较的是大小顺序),不受量纲影响。如果你强行对树模型做标准化,反而会破坏特征的可解释性(分裂阈值变得无意义)。
四、 除缩放外,特征处理的“其他必考三兄弟”
面试官问“特征预处理”往往不局限于缩放,还会考察以下三点,我帮你一并补充进知识体系:
| 预处理类别 | 核心方法 | 面试避坑指南 |
|---|---|---|
| 缺失值处理 | ① 均值/中位数/众数填充;② 回归/插值法填充;③ 直接删除(缺失率>80%);④ 单独设为一类(标注为 Unknown)。 | 千万不要用“0”填充连续型特征(会引入极大的偏置)。对于树模型,将缺失值单独分到左/右子节点是 XGBoost 原生支持的最优解。 |
| 分类特征编码 | ① One-Hot(独热);② LabelEncoder(标签编码);③ Target Encoding(目标编码/均值编码)。 | 陷阱:LabelEncoder 给无序类别强行赋予大小关系(如 红=1,蓝=2),树模型尚可接受,但线性模型绝对禁用!Tree-based 模型用 Target Encoding 需配合 K-Fold 交叉验证防止过拟合。 |
| 异常值处理 | ① 3-Sigma 原则(超出均值±3倍标准差剔除);② IQR 箱线图法(超出上下四分位数1.5倍距);③ 截尾处理(Winsorizing,将极值压到边界值)。 | 异常值不一定都要删!如果是“欺诈检测”,异常值正是你要找的目标,绝对不能删。 |
五、 面试场景题选型指南(必考)
面试官问:“假如我要训练一个 KNN 分类器,特征包含‘年龄(0-100)’和‘年收入(5万-2000万)’,你选归一化还是标准化?为什么?”
你的黄金回答(组合拳):
“我会首选 标准化(StandardScaler)。因为年收入存在极大的长尾分布,可能含有超高净值异常值。若用归一化(MinMax),异常值会严重压缩正常样本的区分度。
进阶操作:如果数据中存在大量极端异常值,我甚至会选择 RobustScaler(鲁棒标准化)——它使用中位数和四分位距(IQR),完全不依赖均值,对异常值几乎免疫。最后,我会在标准化后对收入特征取一次log(1+x)对数变换,进一步拉近尺度差异。”
六、 最终精简版面试记忆卡片(可直接背诵)
Q:请简述特征预处理的方法与选型?
A: 核心是“消除量纲,适配算法”。
- 标准化(StandardScaler):减均值除标准差,输出 0 均值 1 方差。抗异常值能力强,是 KNN、SVM、线性模型等距离类算法的首选。
- 归一化(MinMaxScaler):减最小值除极差,映射到 [0,1]。极度敏感异常值,仅适用于图像像素或确定边界的神经网络输入。
- 绝对红线:缩放操作必须先 Split(拆分数据集),再 Fit(仅拟合训练集),防止数据泄露。
- 特例豁免:树模型(XGBoost/LGB)无需缩放;分类特征禁止乱用 LabelEncoder;异常值需结合业务场景决定剔除还是保留。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 LGQ的博客!